Mantenere coerente un personaggio IA tra generazioni
Genera due volte lo stesso prompt di personaggio e raramente ottieni due volte lo stesso personaggio: il colore dei capelli cambia, la giacca acquisisce un colletto prima assente e il viso sembra quello di un’altra persona. Esistono tecniche reali che riducono il problema ed è utile conoscerne possibilità e limiti, perché la risposta onesta è che gli strumenti attuali non offrono una coerenza completa in modo affidabile.
Perché il personaggio cambia tra i fotogrammi
Un modello di immagini non conserva tra le generazioni un modello interno persistente del “tuo personaggio”, come fa un illustratore che lo tiene a mente mentre disegna una seconda posa. Ogni generazione parte dal rumore ed è modellata dal testo del prompt, dai pesi del modello e da un seed casuale, in gran parte indipendentemente dalle generazioni precedenti, a meno che tu non ne reinserisca esplicitamente una. Due prompt che per te sono identici, con le stesse parole nello stesso ordine, possono comunque portare a punti diversi nello spazio appreso dal modello di “un personaggio corrispondente a questa descrizione”, perché la descrizione lascia indefiniti moltissimi dettagli visivi che il modello deve completare autonomamente, e li completa diversamente ogni volta.
Più che un errore da correggere, questa è una proprietà strutturale del modo in cui questi modelli generano immagini. Ogni tecnica descritta sotto riduce quanto il modello deve completare autonomamente, senza conferirgli una vera memoria di un personaggio specifico.
Cosa fa il blocco del seed e quando smette di essere utile
Un seed è lo stato casuale iniziale della generazione. Usare lo stesso seed con esattamente lo stesso prompt e le stesse impostazioni produce esattamente la stessa immagine: sembra una soluzione completa finché non provi a usarlo per qualcosa di diverso da un’immagine identica. Appena modifichi il prompt, con una nuova posa, uno sfondo diverso o anche soltanto invertendo un paio di parole, il seed non indica più una variante coerente del personaggio. Indica un’immagine diversa che condivide casualmente lo stato iniziale, e non è la stessa cosa.
Il blocco del seed aiuta davvero nelle modifiche limitate e controllate: rigenerare la stessa composizione con un piccolo cambiamento o confrontare l’effetto di due modifiche al prompt su risultati altrimenti identici. È uno strumento diagnostico per isolare l’effetto di un cambiamento specifico al prompt, non un meccanismo per generare «lo stesso personaggio che fa una cosa diversa». Trattalo così e non ti deluderà come quando viene usato come strategia principale per la coerenza.
Fissare colori e materiali nel prompt
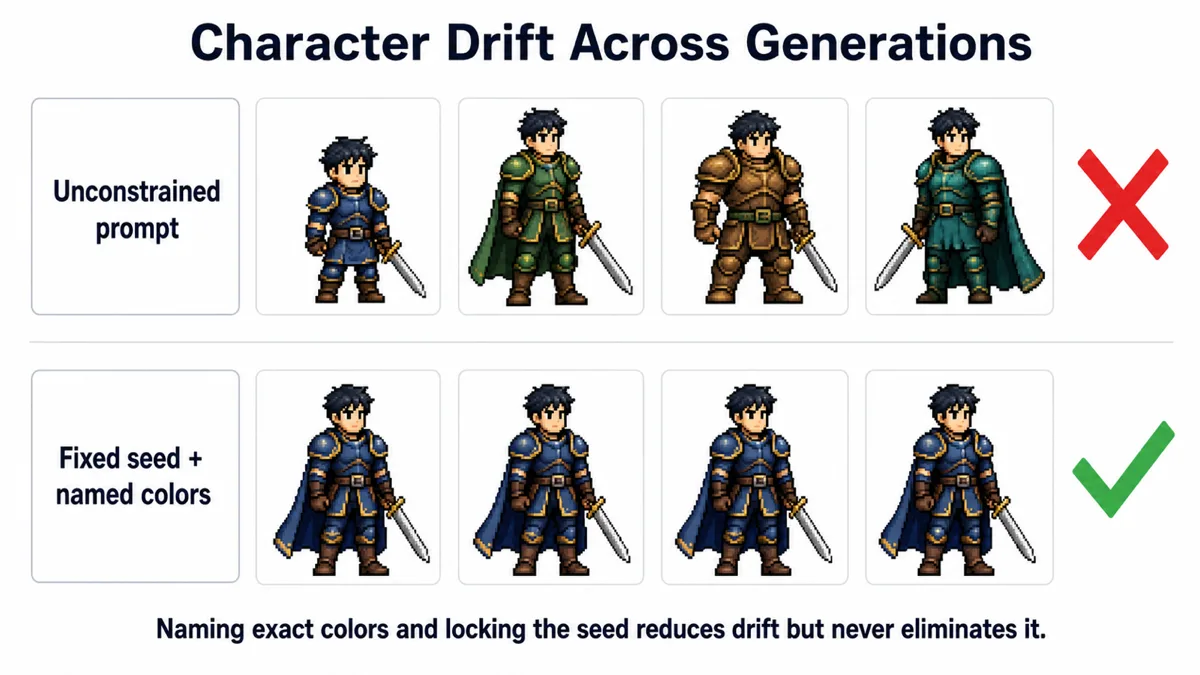
Il cambiamento con il maggiore impatto è descrivere con molta più precisione i dettagli che vuoi davvero mantenere invariati, anziché affidarti al modello perché li deduca in modo coerente. Indicazioni cromatiche vaghe («un cavaliere con un’armatura blu») lasciano spazio a un blu diverso ogni volta. Riferimenti precisi e ripetuti riducono questo margine:
- Specifica sempre i colori esatti allo stesso modo: “armatura a piastre blu cobalto, rifiniture argento opaco, cinturini di cuoio marrone scuro” anziché “armatura blu con pezzi metallici”. Riutilizza la frase identica in ogni prompt del set invece di riformularla per variare.
- Specifica anche il materiale: “cuoio opaco”, “acciaio spazzolato”, “tela usurata”. Influenza ombre e luci e una resa incoerente dei materiali sembra incoerenza anche quando la tonalità è vicina.
- Conserva una scheda scritta del personaggio con le frasi esatte usate e copiale invece di riscrivere ogni volta la descrizione a memoria. Piccole riformulazioni inconsapevoli tra sessioni sono una causa comune ed evitabile di variazioni.
Non produrrà risultati identici pixel per pixel, ma restringe abbastanza le scelte del modello da rendere il personaggio riconoscibilmente lo stesso in tutta la serie, che di solito è il vero requisito di un progetto, anziché la riproduzione esatta.
Generazione da immagine a immagine e immagini di riferimento
Anziché generare solo dal testo, la generazione da immagine a immagine parte da un’immagine esistente, il riferimento stabilito del personaggio, e applica il nuovo prompt come trasformazione vincolata, controllata da intensità o parametro di rimozione del rumore. Una bassa intensità mantiene composizione e colori vicini al riferimento modificando leggermente posa o espressione; una alta torna a trattarlo come punto di partenza libero anziché ancoraggio rigido.
Per mantenere coerente uno specifico elemento del design, questo metodo è decisamente più affidabile del solo prompt testuale, perché il modello ha pixel reali a cui riferirsi invece di una descrizione da reinterpretare da zero. Il compromesso è che la generazione da immagine eredita posa e composizione del riferimento più fortemente della generazione da testo: ottenere una posa molto diversa mantenendo l’intensità abbastanza bassa da preservare il design del personaggio crea una vera tensione. Non esiste un’impostazione che la elimini, solo un intervallo da regolare per ogni generazione.
Alcuni strumenti supportano anche un input dedicato di riferimento o personaggio distinto dal prompt principale, che condiziona stile e identità senza imporre la stessa composizione. Dove disponibile, tende a superare la semplice generazione da immagine a immagine per varietà di pose e coerenza, ma i risultati variano per modello e non sono garantiti.
Genera meno pose per lotto
È invitante chiedere un foglio completo, otto pose e quattro espressioni, in un prompt o lotto, sperando che il modello le consideri un set. In pratica, chiedere molte varianti insieme non rende il modello più coerente sul personaggio: moltiplica soltanto i tentativi indipendenti in cui possono comparire variazioni, senza un ulteriore meccanismo che le leghi.
Generare una o due pose alla volta, confrontarle con il riferimento prima di passare alla successiva ed eliminare o rigenerare subito quelle incoerenti permette di individuare presto le variazioni, quando devi rifare un’immagine invece di scoprire dopo averne generate sedici che metà non corrisponde. È più lento per immagine, ma solitamente più rapido nel complesso, perché non scarti interi grandi lotti.
Correggere le variazioni dopo la generazione: correzione della tavolozza
Anche con prompt accurati, alcune variazioni cromatiche in un set generato sono quasi inevitabili con gli strumenti attuali. Una soluzione pratica è correggerle dopo anziché lottare per una generazione perfetta: scegli l’immagine migliore e più rappresentativa come riferimento cromatico, poi applica una corrispondenza di tavolozza o una correzione colore al resto del set affinché condivida gli stessi valori esatti, non soltanto simili.
Questo non corregge le incoerenze strutturali: un colletto di forma diversa o un viso che sembra appartenere a un’altra persona richiedono una nuova generazione, non una correzione cromatica. Ma nel caso comune di «il personaggio è giusto, tranne la giacca che in tre immagini ha una tonalità di rosso leggermente diversa», un intervento sulla palette in qualsiasi editor di immagini di base colma la differenza in pochi minuti, molto più rapidamente che ripetere le generazioni sperando in una corrispondenza migliore.
Il limite dichiarato con onestà
Nessuna delle tecniche sopra garantisce coerenza, ed è bene dirlo chiaramente: i modelli generici attuali non conservano in modo affidabile il design esatto di un personaggio tra molte generazioni indipendenti, soprattutto con pose, angoli o luci diversi. Alcuni strumenti hanno funzioni dedicate che migliorano le probabilità, ma anche queste producono occasionali discrepanze da individuare con un controllo umano. Prevedi quel passaggio, controllando e scartando o correggendo risultati incoerenti, come parte normale del flusso e non un’eccezione: così il processo rimane realistico anziché combattere lo strumento per risultati che non è ancora progettato a garantire.
Domande frequenti
Usare lo stesso seed per ogni posa manterrà coerente il personaggio?
No: il seed riproduce solo output identici per prompt identici. Cambia il prompt per una nuova posa e il seed smette di essere un ancoraggio significativo. Serve per isolare l’effetto di piccole modifiche al prompt, non per generare varianti dello stesso personaggio.
La generazione da immagine a immagine è sempre migliore di quella da testo a immagine per la coerenza?
È più affidabile nel conservare dettagli visivi specifici, ma porta anche l’output verso posa e composizione del riferimento. Se serve una posa davvero diversa, la generazione da immagine a immagine a bassa intensità può resistere al cambiamento; finisci per bilanciare libertà della posa e coerenza anziché ottenere entrambe gratuitamente.
Quanti dettagli di riferimento dovrei inserire nel prompt?
Abbastanza da fissare i dettagli che ti interessano davvero, come colore dei capelli, colori e materiali dell’abbigliamento e caratteristiche distintive, senza specificare eccessivamente ogni minimo dettaglio. Questo può rendere i prompt fragili e indurre il modello a ignorare parti di una descrizione troppo lunga. Una descrizione mirata e riutilizzata del personaggio funziona meglio di una esaustiva che cambia formulazione ogni volta.
Posso correggere in seguito un viso completamente diverso?
Non con la correzione colore, che risolve solo variazioni cromatiche e tonali. Un viso o un abito strutturalmente diverso è un problema di generazione e va rigenerato, idealmente con un riferimento più forte o un prompt più vincolato, anziché modificato dopo.
Esplora altre guide ai flussi di immagini con IA
La nostra sezione Creatività tratta flussi pratici per set di immagini generati con IA, dai prompt alla post-elaborazione.
Visita Creatività