Mantendo um personagem de IA consistente entre gerações
Gere duas imagens com o mesmo prompt de personagem, e raramente receberá o mesmo personagem nas duas — a cor do cabelo muda, a jaqueta ganha uma gola que não tinha antes, o rosto parece de outra pessoa. Existem técnicas reais para reduzir isso, e vale a pena saber tanto o que fazem quanto o que não conseguem fazer, porque a resposta honesta é que as ferramentas atuais não entregam consistência total de forma confiável.
Por que o personagem muda entre os quadros
Um modelo de imagem não mantém um modelo interno persistente de "seu personagem" entre gerações como um ilustrador mantém um personagem em mente ao desenhar uma segunda pose. Cada geração começa com ruído e é moldada pelo texto do prompt, pelos pesos do modelo e por uma seed aleatória, em grande parte independentemente das gerações anteriores, a menos que você forneça explicitamente uma delas como entrada. Dois prompts que parecem idênticos para você — mesmas palavras, mesma ordem — ainda podem chegar a pontos diferentes no espaço aprendido pelo modelo de "um personagem que corresponde a esta descrição", porque a descrição não especifica um número enorme de detalhes visuais que o modelo precisa preencher sozinho, e ele os preenche de maneira diferente a cada vez.
Isso não é tanto um erro a corrigir, mas uma propriedade estrutural de como esses modelos geram imagens. Todas as técnicas abaixo funcionam reduzindo o quanto o modelo precisa completar por conta própria, não dando a ele uma memória real de um personagem específico.
O que fixar a seed faz e quando deixa de ajudar
Uma seed é o estado aleatório inicial da geração. Usar a mesma seed com exatamente o mesmo prompt e as mesmas configurações produz exatamente a mesma imagem, o que parece uma solução completa até você tentar usá-la para algo que não seja uma imagem idêntica. No momento em que altera qualquer coisa no prompt — uma nova pose, outro fundo, até a ordem de algumas palavras —, a seed deixa de apontar para uma variação consistente do personagem. Ela aponta para outra imagem que, por acaso, compartilha o mesmo estado aleatório inicial, o que não é a mesma coisa.
Fixar a seed realmente ajuda em edições pequenas e controladas: gerar novamente a mesma composição com uma pequena mudança ou comparar como dois ajustes de prompt afetam uma saída que, fora isso, seria idêntica. É uma ferramenta de depuração para isolar o efeito de uma mudança específica no prompt, não um mecanismo para gerar "o mesmo personagem fazendo outra coisa". Trate-a assim, e ela não decepcionará como acontece quando é usada como estratégia principal de consistência.
Fixando cor e material no prompt
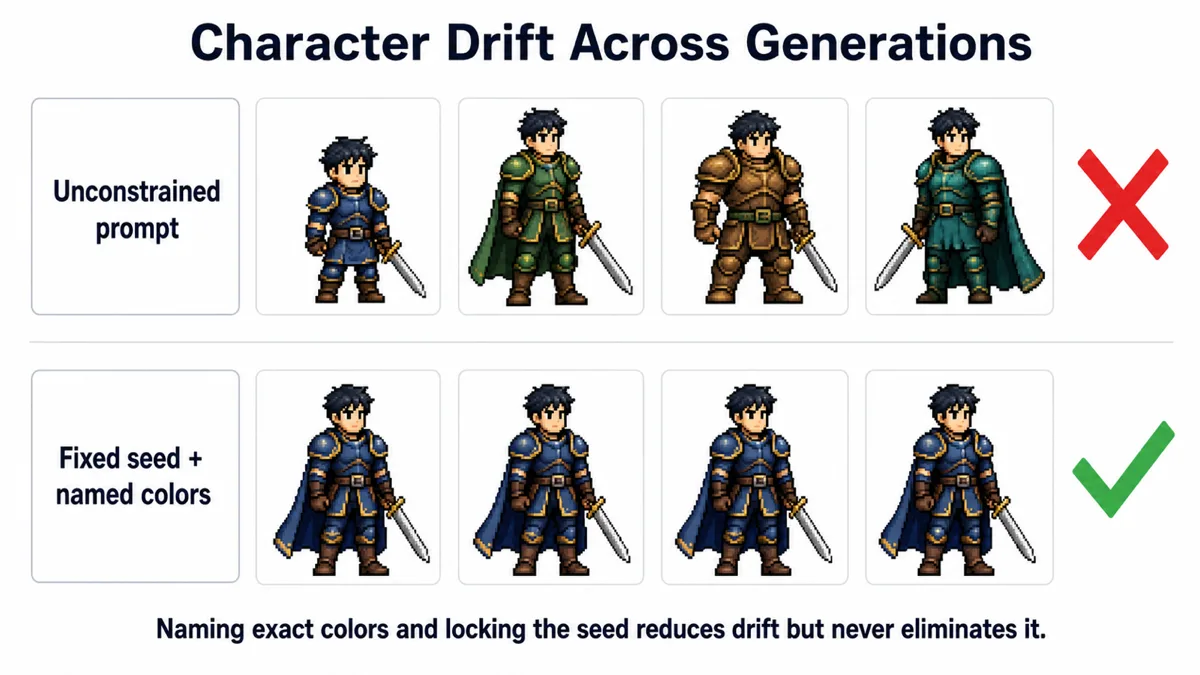
A mudança de maior impacto é ser muito mais específico sobre os detalhes que você realmente quer manter fixos, em vez de confiar que o modelo vai deduzi-los consistentemente. Descrições vagas de cor ("um cavaleiro de armadura azul") deixam espaço para um azul diferente a cada vez. Uma ancoragem específica e repetida reduz esse espaço:
- Nomeie as cores exatas da mesma forma todas as vezes — "armadura de placas azul-cobalto, detalhes prateados foscos, tiras de couro marrom-escuro", em vez de "armadura azul com algumas partes de metal". Reutilize a mesma frase em todos os prompts do conjunto, em vez de reformulá-la para variar.
- Especifique o material junto com a cor — "couro fosco", "aço escovado", "lona desgastada" — porque o material afeta como o modelo renderiza sombras e brilhos, e uma renderização de material diferente parece inconsistente mesmo quando o tom é tecnicamente próximo.
- Mantenha uma ficha escrita do personagem com as frases exatas que usa e copie dela, em vez de redigitar a descrição de memória a cada vez. Pequenas mudanças inconscientes de redação entre sessões são uma fonte comum e evitável de variações.
Isso não produzirá resultados idênticos pixel a pixel, mas limita as escolhas do modelo o suficiente para que o personagem seja reconhecido como o mesmo em todo o conjunto, o que normalmente é o requisito real de um projeto, em vez de reprodução exata.
Geração de imagem para imagem e imagens de referência
Em vez de gerar apenas a partir de texto, a geração de imagem para imagem começa com uma imagem existente — sua referência já definida do personagem — e aplica o novo prompt como uma transformação limitada dela, controlada por um parâmetro de intensidade ou remoção de ruído. Uma intensidade baixa mantém a saída próxima da composição e das cores da referência, enquanto altera levemente a pose ou a expressão; uma intensidade alta tende a tratá-la como um ponto de partida flexível, em vez de uma base rígida.
Isso é significativamente mais confiável que usar apenas prompts de texto para manter um elemento específico de design consistente, porque o modelo tem pixels reais como referência, em vez de uma descrição textual que precisa reinterpretar do zero. A contrapartida é que imagem para imagem herda a pose e a composição da referência com mais força que texto para imagem. Assim, buscar uma pose muito diferente mantendo a intensidade baixa o bastante para preservar o design do personagem cria uma tensão real — não há configuração que a elimine, apenas uma faixa que você ajusta a cada geração.
Algumas ferramentas também aceitam uma entrada específica de referência ou imagem do personagem, separada do prompt principal de geração, que orienta o estilo e a identidade a partir dessa referência sem impor a mesma composição. Quando disponível, isso tende a superar a geração comum de imagem para imagem na variedade de poses, mantendo a identidade do personagem, embora os resultados ainda variem conforme o modelo e não sejam garantidos.
Gere menos poses por lote
É tentador pedir uma folha completa — oito poses, quatro expressões — em um prompt ou lote, esperando que o modelo trate tudo como um conjunto. Na prática, pedir muitas variações de uma vez não faz o modelo manter o personagem mais consistente; apenas multiplica o número de tentativas independentes em que pode haver variação, sem um mecanismo adicional de consistência que as conecte.
Gerar uma ou duas poses por vez, conferir cada uma com a referência antes de passar à próxima e descartar ou gerar novamente as discrepantes imediatamente identifica as variações cedo, quando há uma imagem para refazer, em vez de descobrir após gerar dezesseis que metade não combina. É mais lento por imagem, mas normalmente mais rápido no total, porque você não joga fora grandes lotes inteiros.
Corrigindo variações após a geração: correção de paleta
Mesmo com prompts cuidadosos, alguma variação de cor em um conjunto gerado é quase inevitável com as ferramentas atuais. Uma alternativa prática é corrigir depois, em vez de insistir em uma geração perfeita: escolha sua melhor imagem, a mais representativa, como referência de cor e aplique uma correspondência de paleta ou correção de cores ao restante do conjunto para que todos compartilhem os mesmos valores exatos de cor, e não apenas valores semelhantes.
Isso não corrige inconsistências estruturais — um formato de gola diferente ou um rosto que parece outra pessoa precisa ser gerado novamente, não ter sua cor corrigida. Mas, no caso comum de "o personagem está certo, só que a jaqueta tem um tom de vermelho ligeiramente diferente em três destas imagens", um ajuste de paleta em qualquer editor básico de imagens resolve a diferença em minutos, muito mais rápido que repetir gerações na esperança de uma correspondência melhor.
O limite real
Nada disso garante consistência, e vale dizer claramente: os modelos atuais de imagem de uso geral não mantêm de forma confiável o design exato de um personagem entre muitas gerações independentes, especialmente com poses, ângulos ou iluminação diferentes. Algumas ferramentas têm recursos específicos de consistência de personagens que melhoram as chances, mas até eles produzem diferenças ocasionais que precisam de revisão humana. Reserve tempo para essa revisão — conferir e descartar ou corrigir resultados discrepantes — como parte normal do fluxo, não uma exceção, e o processo continuará realista, em vez de você lutar com a ferramenta por resultados que ela ainda não foi feita para garantir.
Perguntas frequentes
Usar a mesma seed para todas as poses manterá o personagem consistente?
Não — a seed só reproduz uma saída idêntica para um prompt idêntico. Altere o prompt para uma nova pose, e a seed deixa de ser uma âncora relevante. Ela é útil para isolar o efeito de pequenas mudanças no prompt, não para gerar variações do mesmo personagem.
A geração de imagem para imagem é sempre melhor que a de texto para imagem para manter consistência?
Ela é mais confiável para preservar detalhes visuais específicos, mas também aproxima a saída da pose e composição existentes na referência. Se precisar de uma pose realmente diferente, a geração de imagem para imagem com baixa intensidade pode resistir à mudança; você acaba equilibrando liberdade de pose e consistência, em vez de obter ambas sem esforço.
Quantos detalhes de referência devo colocar no prompt?
O suficiente para fixar os detalhes que realmente importam para você — cor do cabelo, cores e materiais da roupa, características marcantes — sem especificar demais cada detalhe menor, o que pode tornar os prompts frágeis e fazer o modelo ignorar partes de uma descrição longa demais. Uma descrição focada do personagem, reutilizada, funciona melhor que uma descrição exaustiva cuja redação muda a cada vez.
Posso corrigir um rosto completamente diferente depois?
Não com correção de cores — ela só trata variações de cor e tom. Um rosto ou roupa estruturalmente diferente é um problema de geração e precisa ser gerado novamente, idealmente com uma imagem de referência mais forte ou um prompt mais preciso, em vez de ser editado depois.
Explore mais guias de fluxos de trabalho com imagens e IA
Nossa seção Criatividade aborda fluxos de trabalho práticos para conjuntos de imagens geradas por IA, desde a criação de prompts até o pós-processamento.
Visite Criatividade